Claude Fable 5 yangi sanoat benchmarklarida yetakchi bo‘ldi, ammo narxi ancha qimmat

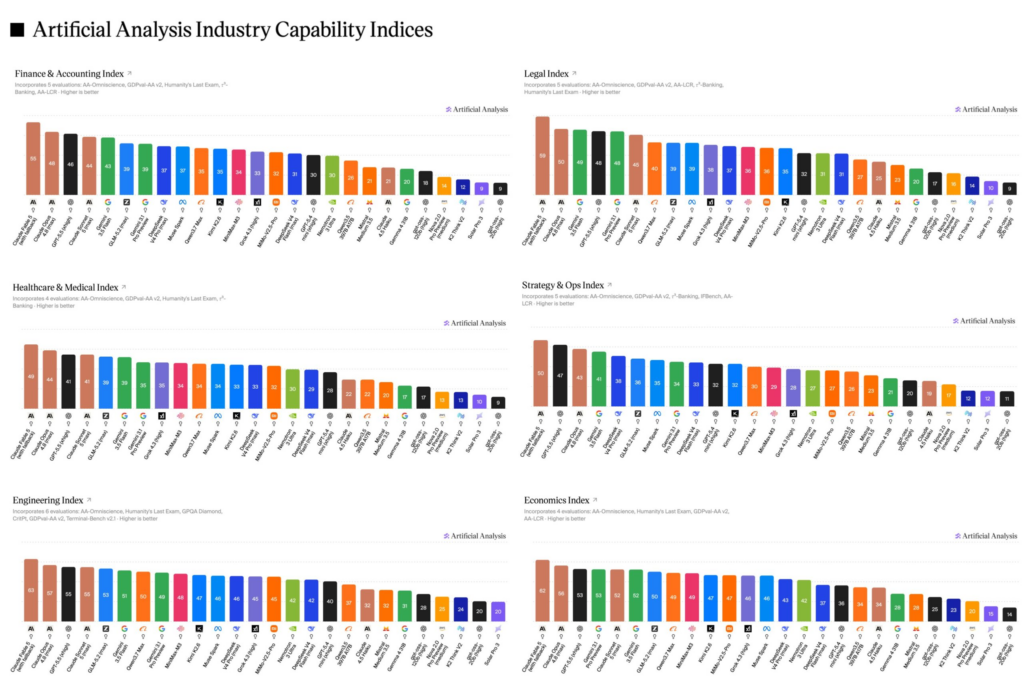
AI modellarini baholovchi Artificial Analysis platformasi sun’iy intellekt modellarining turli kasbiy sohalardagi imkoniyatlarini o‘lchash uchun oltita yangi Capability Index (Imkoniyatlar indeksi)ni taqdim etdi. Yangi reytinglar moliya, huquq, tibbiyot, strategiya va operatsiyalar, muhandislik hamda iqtisodiyot yo‘nalishlarini qamrab oladi.
Yangi indekslar platformaning avvaldan mavjud bo‘lgan Agentic va Coding benchmarklarini to‘ldirib, AI modellarining aniq sohalardagi amaliy samaradorligini baholash imkonini beradi.
Benchmarklar qanday tuzilgan?
Artificial Analysis ma’lumotlariga ko‘ra, baholash metodologiyasi AQShdagi O*NET kasblar tasnifi tizimiga asoslangan. Har bir yo‘nalish uchun shu sohaga xos bo‘lgan ish vazifalari tanlab olingan.
Masalan, moliya yo‘nalishida moliyaviy modellashtirish va tahlil, huquq sohasida yuridik tadqiqotlar hamda shartnomalarni tahlil qilish, tibbiyotda esa klinik qarorlarni qo‘llab-quvvatlash kabi vazifalar benchmark tarkibiga kiritilgan.
Har bir sanoat uchun testlar alohida shakllantirilgan bo‘lib, vazifalarning ulushi ularning real hayotda qanchalik ko‘p uchrashiga qarab belgilangan. Artificial Analysis barcha benchmarklar mustaqil ravishda ishga tushirilganini ta’kidlaydi.
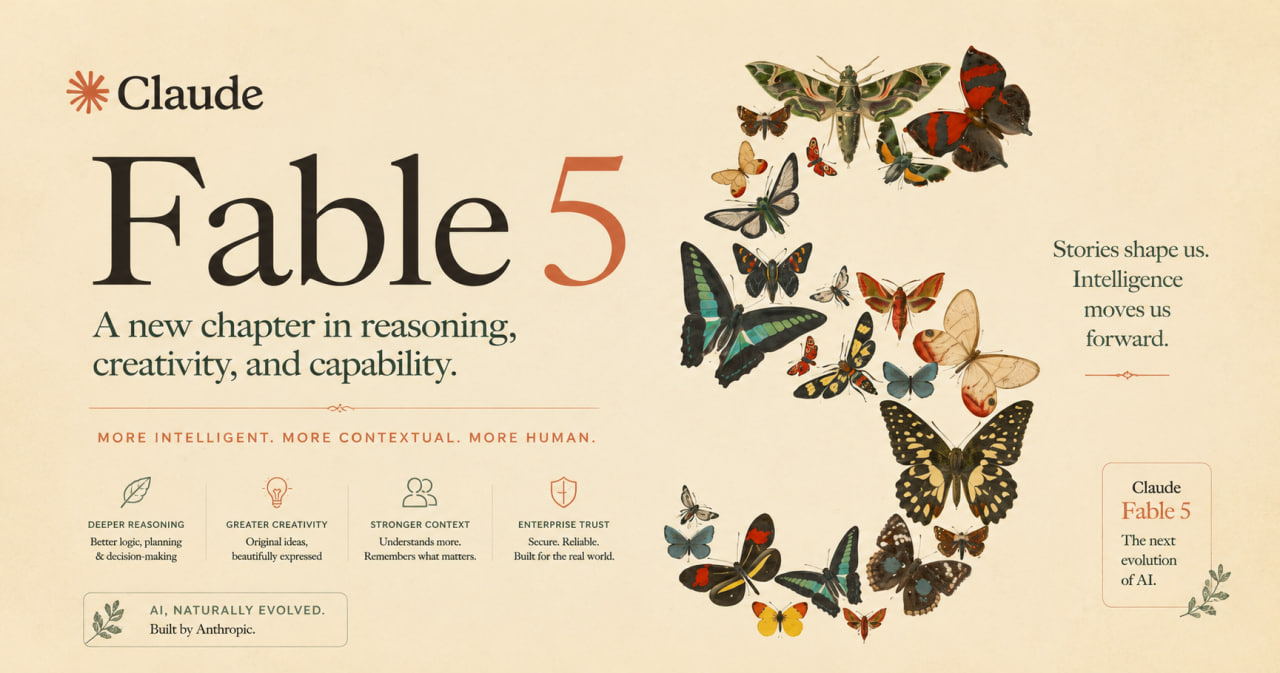
Claude Fable 5 barcha sakkizta indeksda birinchi
Natijalarga ko‘ra, Anthropic’ning Claude Fable 5 modeli (zarurat tug‘ilganda Claude Opus 4.8’dan foydalanadi) platformadagi barcha sakkizta indeksda birinchi o‘rinni egalladi.
Sakkizta indeksning oltitasida ikkinchi o‘rinni Claude Opus 4.8 (max) egallagan bo‘lsa, qolgan ikki indeksda OpenAI GPT-5.5 (xhigh) ikkinchi natijani qayd etdi.
Artificial Analysis ta’kidlashicha, yaqin kunlarda taqdim etilishi rejalashtirilgan GPT-5.6 Anthropic va OpenAI o‘rtasidagi farqni qisqartirishi mumkin.
Turli sohalarda turli modellar kuchli
Eng yuqori pog‘onadan keyingi o‘rinlarda esa reyting sohalarga qarab sezilarli darajada o‘zgaradi.
Quyidagi modellar turli yo‘nalishlarda o‘zaro almashib turadigan natijalarni ko‘rsatgan:
- Gemini 3.5 Flash
- Gemini 3.1 Pro Preview
- GPT-5.5 (xhigh)
- Claude Sonnet 5 (max)
- GLM-5.2 (max)
Open-weight (ochiq vaznli) modellar orasida GLM-5.2 (max) oltita sanoat indeksining beshtasida yetakchilik qildi.
Muhandislik benchmarkida GLM-5.2 53 ball to‘plab umumiy reytingda beshinchi o‘rinni egalladi. U Claude Sonnet 5 va GPT-5.5’dan atigi ikki ball ortda qoldi.
Strategy & Ops indeksida esa open-weight modellar orasida DeepSeek V4 Pro (max) 38 ball bilan birinchi bo‘ldi.
Natijalar LMArena reytinglari bilan ham mos kelmoqda
Artificial Analysis natijalari millionlab foydalanuvchilarning anonim taqqoslashlariga asoslangan LMArena reytinglari bilan ham mos tushmoqda.
7-iyul holatiga ko‘ra, Claude Fable 5:
- Text Arena reytingida;
- Code Arena reytingida;
- Agent Arena reytingida
birinchi o‘rinni egallab turibdi.
Shu tariqa Anthropic hozircha uchala asosiy kategoriya bo‘yicha yetakchilik qilayotgan yagona AI laboratoriyasi hisoblanadi.
Agent Arena reytingida Claude Fable 5 model o‘rtacha ko‘rsatkichidan 16,58% yuqori natija qayd etgan. Taqqoslash uchun, GPT-5.5 xHigh 8,66%, Z.ai’ning GLM 5.2 modeli esa 6,62% natija ko‘rsatgan.
Text Arena reytingida OpenAI 10-o‘rinda, Google 7-o‘rinda, DeepSeek esa 38-o‘rinda joylashgan.
Eng yaxshi model, ammo eng qimmat model ham
Benchmark natijalari yana bir muhim jihatni ko‘rsatmoqda — eng yuqori sifat odatda ancha yuqori narx bilan birga keladi.
Artificial Analysis hisob-kitoblariga ko‘ra:
- DeepSeek V4 Flash (max) oltita sanoat yo‘nalishidagi vazifalarni bitta topshiriq uchun 0,04 dollardan kam xarajat bilan bajara oladi.
- GLM-5.2 (max) esa ochiq vaznli modellar orasida 0,26–0,58 dollar oralig‘idagi xarajat bilan eng yaxshi natijani taqdim etadi.
Bunga qarshi ravishda, Claude Fable 5 Strategy & Ops indeksidagi bitta vazifa uchun o‘rtacha 3,48 dollar sarflaydi.
Bu DeepSeek V4 Pro‘ning 0,03 dollarlik xarajatidan yuz martadan ham ko‘proq. Biroq ikki model o‘rtasidagi natija farqi atigi 12 ballni tashkil etadi.
Artificial Analysis avvalgi benchmarklarda ham Claude Fable 5’ning nisbatan kichik sifat ustunligi juda katta narx evaziga qo‘lga kiritilishini qayd etgan edi.
Korxonalar uchun asosiy savol
Bugungi kunda kompaniyalar uchun asosiy savol — eng kuchli model uchun bir necha baravar ko‘proq to‘lash qanchalik o‘zini oqlaydi?
Ko‘plab tashkilotlar murakkab vazifalarni kuchli frontier modellariga, oddiy va takrorlanuvchi ishlarni esa arzonroq modellar zimmasiga yuklash strategiyasini sinab ko‘rmoqda. Bu yondashuv sifatni saqlagan holda xarajatlarni sezilarli darajada kamaytirishga yordam beradi.
Shu bilan birga, iqtisodchi va sun’iy intellekt tadqiqotchisi Ethan Mollick kabi ayrim mutaxassislar Claude Fable 5 kabi modellar ustunligini hozirgi benchmarklar to‘liq aks ettira olmayotganini ta’kidlamoqda. Biroq hozircha bu fikrni tasdiqlovchi aniq dalillar mavjud emas.
Artificial Analysis yangi indekslarning to‘liq metodologiyasi, baholash mezonlari va benchmark tarkibini o‘z platformasida ochiq e’lon qilgan.